This is an automated email from the ASF dual-hosted git repository.

zjffdu pushed a commit to branch master
in repository https://gitbox.apache.org/repos/asf/zeppelin.git
The following commit(s) were added to refs/heads/master by this push:
new a603960 [ZEPPELIN-5366] Run spark job as the login user in yarn mode
a603960 is described below
commit a6039600124717cf5b355eb511740c9177bf7e26
Author: Jeff Zhang <[email protected]>
AuthorDate: Thu Jul 1 15:34:06 2021 +0800
[ZEPPELIN-5366] Run spark job as the login user in yarn mode
### What is this PR for?
Introduce new flink configuration `zeppelin.spark.run.asLoginUser` to
control whether run the spark job as the login user in yarn mode.
### What type of PR is it?
[ Feature ]
### Todos
* [ ] - Task
### What is the Jira issue?
* https://issues.apache.org/jira/browse/ZEPPELIN-5366
### How should this be tested?
* CI pass
### Screenshots (if appropriate)
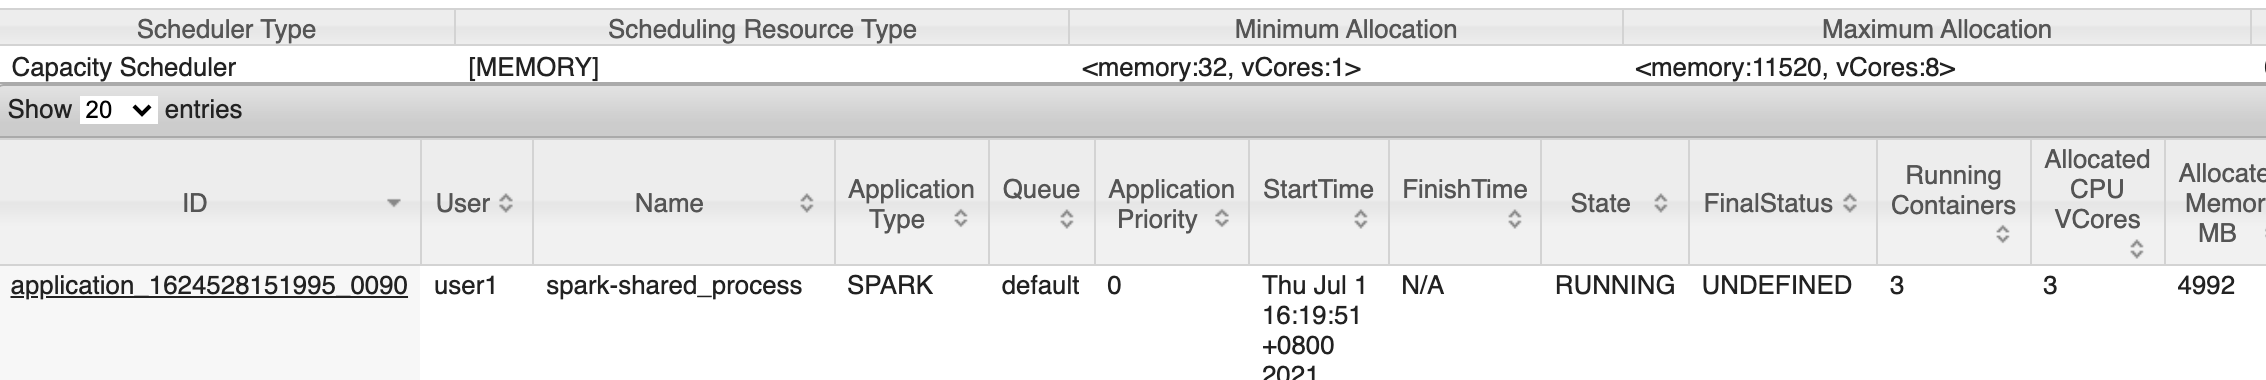
### Questions:
* Does the licenses files need update? No
* Is there breaking changes for older versions? No
* Does this needs documentation? No
Author: Jeff Zhang <[email protected]>
Closes #4159 from zjffdu/ZEPPELIN-5366 and squashes the following commits:
2891e9d4ce [Jeff Zhang] [ZEPPELIN-5366] Run spark job as the login user in
yarn mode
---
docs/interpreter/spark.md | 5 +++++
spark/interpreter/src/main/resources/interpreter-setting.json | 8 ++++++++
.../org/apache/zeppelin/integration/SparkIntegrationTest.java | 2 ++
.../zeppelin/interpreter/launcher/SparkInterpreterLauncher.java | 9 +++++++++
4 files changed, 24 insertions(+)
diff --git a/docs/interpreter/spark.md b/docs/interpreter/spark.md
index 0d3fb00..fd0356d 100644
--- a/docs/interpreter/spark.md
+++ b/docs/interpreter/spark.md
@@ -172,6 +172,11 @@ You can also set other Spark properties which are not
listed in the table. For a
<td>Max number rows of Spark SQL result to display.</td>
</tr>
<tr>
+ <td>zeppelin.spark.run.asLoginUser</td>
+ <td>true</td>
+ <td>Whether run spark job as the zeppelin login user, it is only applied
when running spark job in hadoop yarn cluster and shiro is enabled.</td>
+ </tr>
+ <tr>
<td>zeppelin.spark.printREPLOutput</td>
<td>true</td>
<td>Print scala REPL output</td>
diff --git a/spark/interpreter/src/main/resources/interpreter-setting.json
b/spark/interpreter/src/main/resources/interpreter-setting.json
index 9d70f9c..1502f64 100644
--- a/spark/interpreter/src/main/resources/interpreter-setting.json
+++ b/spark/interpreter/src/main/resources/interpreter-setting.json
@@ -97,6 +97,14 @@
"type": "checkbox"
},
+ "zeppelin.spark.run.asLoginUser": {
+ "envName": null,
+ "propertyName": "zeppelin.spark.run.asLoginUser",
+ "defaultValue": true,
+ "description": "Whether run spark job as the zeppelin login user, it
is only applied when running spark job in hadoop yarn cluster and shiro is
enabled",
+ "type": "checkbox"
+ },
+
"zeppelin.spark.printREPLOutput": {
"envName": null,
"propertyName": "zeppelin.spark.printREPLOutput",
diff --git
a/zeppelin-interpreter-integration/src/test/java/org/apache/zeppelin/integration/SparkIntegrationTest.java
b/zeppelin-interpreter-integration/src/test/java/org/apache/zeppelin/integration/SparkIntegrationTest.java
index 1929060..5802780 100644
---
a/zeppelin-interpreter-integration/src/test/java/org/apache/zeppelin/integration/SparkIntegrationTest.java
+++
b/zeppelin-interpreter-integration/src/test/java/org/apache/zeppelin/integration/SparkIntegrationTest.java
@@ -195,6 +195,7 @@ public abstract class SparkIntegrationTest {
sparkInterpreterSetting.setProperty("zeppelin.spark.scala.color", "false");
sparkInterpreterSetting.setProperty("zeppelin.spark.deprecatedMsg.show",
"false");
sparkInterpreterSetting.setProperty("spark.user.name", "#{user}");
+ sparkInterpreterSetting.setProperty("zeppelin.spark.run.asLoginUser",
"false");
try {
setUpSparkInterpreterSetting(sparkInterpreterSetting);
@@ -244,6 +245,7 @@ public abstract class SparkIntegrationTest {
sparkInterpreterSetting.setProperty("zeppelin.spark.scala.color", "false");
sparkInterpreterSetting.setProperty("zeppelin.spark.deprecatedMsg.show",
"false");
sparkInterpreterSetting.setProperty("spark.user.name", "#{user}");
+ sparkInterpreterSetting.setProperty("zeppelin.spark.run.asLoginUser",
"false");
try {
setUpSparkInterpreterSetting(sparkInterpreterSetting);
diff --git
a/zeppelin-zengine/src/main/java/org/apache/zeppelin/interpreter/launcher/SparkInterpreterLauncher.java
b/zeppelin-zengine/src/main/java/org/apache/zeppelin/interpreter/launcher/SparkInterpreterLauncher.java
index 932cf45..440b249 100644
---
a/zeppelin-zengine/src/main/java/org/apache/zeppelin/interpreter/launcher/SparkInterpreterLauncher.java
+++
b/zeppelin-zengine/src/main/java/org/apache/zeppelin/interpreter/launcher/SparkInterpreterLauncher.java
@@ -230,6 +230,15 @@ public class SparkInterpreterLauncher extends
StandardInterpreterLauncher {
LOGGER.warn("spark-defaults.conf doesn't exist: {}",
sparkDefaultFile.getAbsolutePath());
}
+ if (isYarnMode()) {
+ boolean runAsLoginUser = Boolean.parseBoolean(context
+ .getProperties()
+ .getProperty("zeppelin.spark.run.asLoginUser", "true"));
+ String userName = context.getUserName();
+ if (runAsLoginUser && !"anonymous".equals(userName)) {
+ env.put("HADOOP_USER_NAME", userName);
+ }
+ }
LOGGER.info("buildEnvFromProperties: {}", env);
return env;

